输入网址,整站打包下载:Website-downloader 实操指南
项目卡片
项目:Website-downloader[1] 状态:4.4k Star / 1k Fork / MIT 协议 / 持续维护中 一句话判断:基于 wget 的整站下载器,Web UI + 实时进度,适合快速离线备份静态站点
我之前备份一个旧文档站时,试过用浏览器插件逐页保存,结果 CSS 和图片漏了一大半,页面打开全是乱的。后来用 wget 命令行,能抓全但要自己拼参数、压 zip,步骤不少。
Website-downloader 把这条链路缩短成了一个 Web 页面:输入 URL,点一下,等进度跑完,下载 zip。核心就是 wget + archiver,但它帮你把参数调好了、进度接上了、压缩也自动化了。
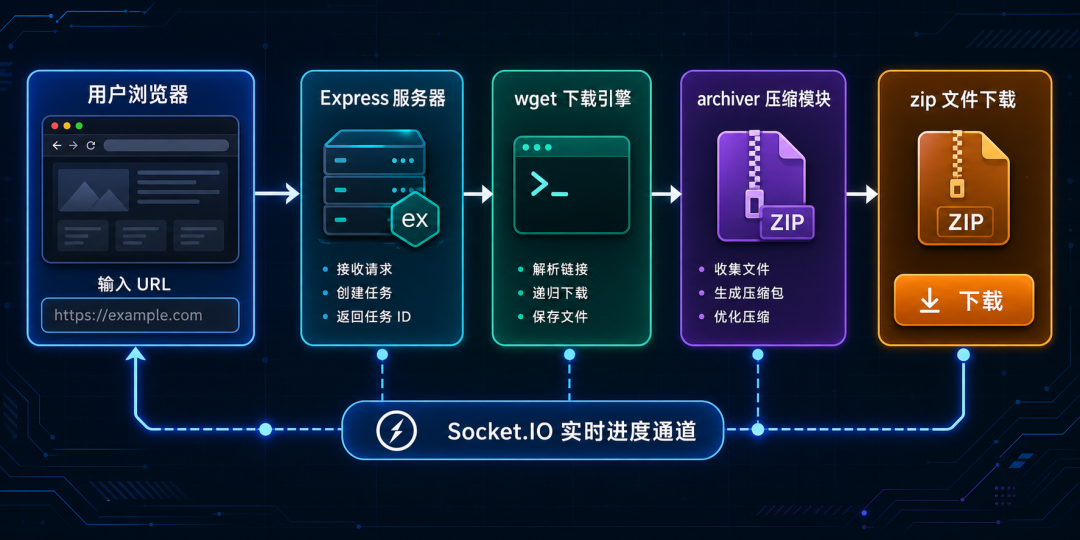
整个流程只有三步,没有数据库,没有队列,架构极简:
-
用户在网页输入 URL,点击下载 -
后端执行 wget -mkEpnp,递归抓取页面及其所有依赖资源 -
下载完成后用 archiver 压缩成 zip,通过 Socket.IO 推送进度,用户点击下载
wget 的参数组合决定了抓取质量:
-
-m(mirror):递归下载,自动跟踪链接 -
-k(convert-links):把绝对链接转为相对路径,离线浏览时资源不断链 -
-E(adjust-extension):根据 Content-Type 给文件加.html/.css后缀 -
-p(page-requisites):下载 CSS、图片、JS 等页面渲染必需资源 -
-np(no-parent):不向上递归,限制在目标目录内
这套参数组合是 wget 社区做离线镜像的经典配置。项目没有做额外的 URL 解析或资源发现逻辑,完全依赖 wget 本身的能力。
环境要求:Node.js + 系统自带 wget(Linux / macOS 默认都有,Windows 需要单独安装)。
git clone https://github.com/AhmadIbrahiim/Website-downloader.git
cd Website-downloader
npm install
npm start
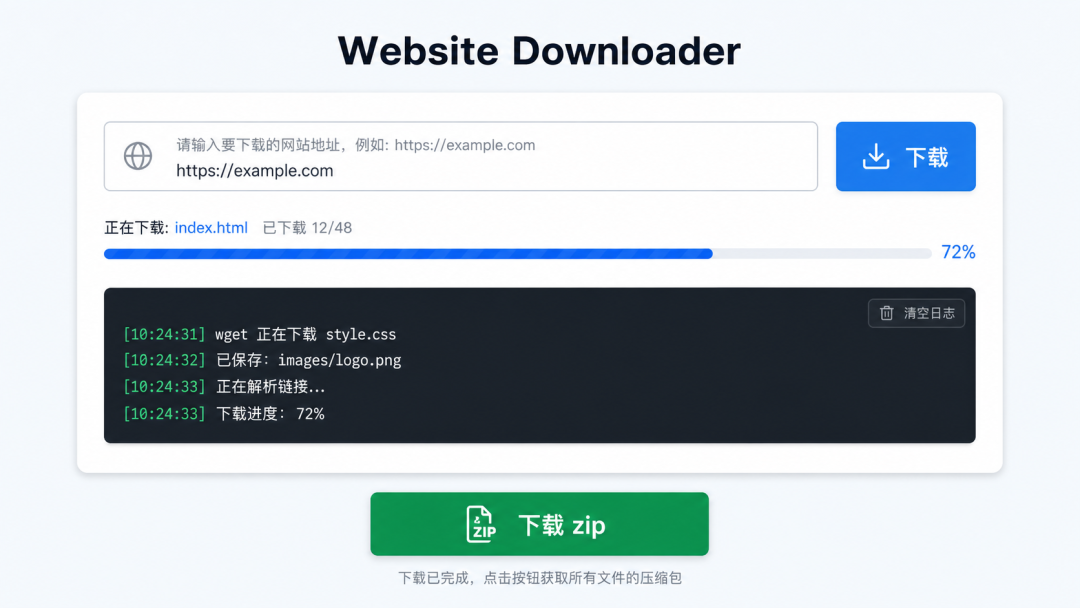
打开 http://localhost:3000,输入目标网址,点击下载按钮即可。
进度条会实时显示当前正在下载的文件和已下载数量。下载完成后页面出现绿色按钮,点击就能拿到 zip 包。zip 文件保存在 public/sites/ 目录下。
适合抓什么类型的站
静态站点、文档站、博客、产品官网——我试了几个,wget 处理得都不错。页面内容由服务端渲染,资源路径清晰,mirror 模式基本不会漏。
不太适合的场景
SPA(单页应用):React / Vue / Angular 构建的站点,内容由 JS 动态渲染,wget 拿到的只是空壳 HTML。如果你需要抓这类站点,得换 Puppeteer 或 Playwright 这类 headless browser 方案。
需要登录的页面:wget 默认不带 Cookie 和 Session,抓到的是登录前的内容。
动态 API 数据:wget 只抓静态资源,不会执行 XHR 请求。
大站慎用
wget 的 mirror 模式会递归跟踪所有链接。如果你给它一个大型站点(比如一个有几千页的电商站),它会尝试全部下载。--no-parent 能限制范围,但没有深度限制参数——实际用的时候,建议先指定具体子目录而不是整站根域名。
部署到云平台
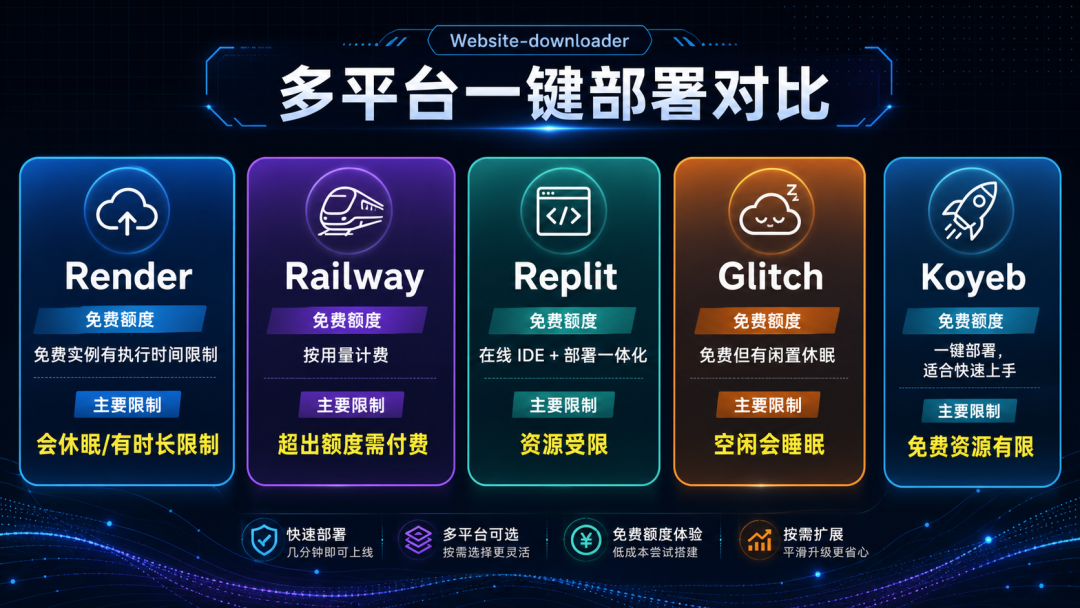
项目提供了 Render、Railway、Replit、Glitch、Koyeb 等多个平台的一键部署按钮。以 Render 为例,Fork 仓库后在 Render Dashboard 选择 New Web Service,关联你的 Fork,保持默认配置即可部署。
不过要注意:免费实例通常有执行时间限制,大站点下载可能超时。如果需要稳定使用,建议部署到有足够资源的实例上。
| 方案 | 优势 | 劣势 |
|---|---|---|
| Website-downloader | 开源免费、Web UI、实时进度 | 依赖 wget、不支持 SPA |
| HTTrack | 功能更全、支持过滤规则 | 命令行操作、学习成本高 |
| 浏览器插件(如 SingleFile) | 单页保存方便 | 无法递归抓取整站 |
| wget 直接命令行 | 最灵活 | 没有 UI、进度不直观 |
说白了,Website-downloader 是 wget 的一个轻量 Web 包装。它的价值不在功能比 wget 强,而是帮你跳过了拼参数、看日志、手动压缩这几步。如果你需要过滤规则、认证、断点续传,HTTrack 或裸 wget 脚本更合适。
代码量很小,核心就两个文件:wget/index.js 负责下载,archiver/index.js 负责压缩。我翻了一遍源码,改动门槛不高,几个实际有用的方向:
加深度限制:wget 命令里加 -l 3 就行,限制递归层级防止抓取失控。这可能是最实用的改进——原版没有深度限制,大站容易跑飞。
让用户传自定义参数:前端加个输入框,后端拼接到 wget 命令里。这样不用改代码就能支持 Cookie、代理、限速等场景。
定时清理 zip 文件:当前 zip 文件会一直堆在 public/sites/ 目录,时间长了磁盘会被吃满。加个 cron 或者在 archiver 完成后清理超过 1 小时的旧文件就够了。
这里会继续拆真实可用的开发者工具:少讲概念,多看入口、成本和坑点。你只需要判断一件事——它值不值得放进自己的工作流。
引用链接
[1]Website-downloader: https://github.com/AhmadIbrahiim/Website-downloader